Demo

Ein Schweizer Netzwerk, das es nicht gibt. Bringen Sie es aus dem Tritt, dann fragen Sie shift.

In der Demo arbeitet shift mit echten MCP-Servern und einem simulierten Firmennetzwerk. Nichts darin gehört einem Kunden: Geräte, Verkehr und Logs stammen aus einem Simulator.

Schon Zugang? Demo öffnen

Zugang

So erhalten Sie Zugang

Die Demo ist für namentlich bekannte Personen. Schreiben Sie uns, und wir richten Ihnen ein Konto beim Anmeldedienst der Demo ein. Sie melden sich dann einmal mit einem Code per E-Mail an und richten einen Passkey ein; ein Passwort gibt es nicht. Eine Anmeldung gilt eine Woche.

  1. Senden Sie die Anfrage unten. Sagen Sie uns, was Sie sehen möchten: das Netzwerk, den Shop in Kubernetes oder beides, und ob Sie auch etwas kaputt machen möchten.
  2. Wir richten Ihr Konto ein, meist innert eines Arbeitstags.
  3. Sie erhalten eine E-Mail vom Anmeldedienst der Demo. Melden Sie sich an, fügen Sie einen Passkey hinzu und öffnen Sie die Demo.
Demo-Zugang anfragen

Öffnet Ihr E-Mail-Programm mit einer vorbereiteten Nachricht an hello@zebbra.ch.

Bevor Sie loslegen

Die Demo gehört uns, nicht Ihnen: Sie läuft auf der Infrastruktur von zebbra mit einem gehosteten Modell, und was Sie eingeben, geht an dessen Anbieter. Bitte geben Sie keine echten Daten aus Ihrem Netzwerk ein.

Sie möchten shift an Ihrem eigenen Netzwerk sehen? Schreiben Sie uns für einen Test auf Ihrer Infrastruktur.

Was Sie vorfinden

Jedes Tool der Demo hat ein Admin geprüft, wie in einer echten Installation. Das Log eines Pods zu lesen ist Sensitive, darum fragt shift Sie zuerst.

LTE-Backup mpls-cloud BRN Bern ZRH Zürich BSL Basel GVA Genève LUG Lugano
  • Das Netzwerk.

    Fünf Standorte: Bern (Hauptsitz und Rechenzentrum), Zürich, Basel, Genf und Lugano mit LTE-Backup. Router, Switches, Firewalls, WLAN und Server, erfasst in NetBox.

  • Metriken und Logs.

    VictoriaMetrics enthält Interface-Verkehr, Fehler, Uptime und Erreichbarkeit; VictoriaLogs das Syslog jedes Geräts.

  • Störungen.

    Nach Fahrplan: Alle 90 Minuten flappt ein Link, alle zwei Stunden läuft ein Uplink voll, alle drei Stunden startet ein Gerät neu. Jede Episode endet von selbst.

  • Ein Webshop in Kubernetes.

    Der Astronomy Shop der OpenTelemetry Demo, rund 15 Services in einem eigenen Namespace, mit einem Lastgenerator als Kundschaft. Seine Feature-Flags machen ihn absichtlich kaputt: fehlschlagende Zahlungen, ein abstürzender Warenkorb, ein Cache mit Speicherleck, ein Rückstau in Kafka.

  • Grafana und Alarme.

    Dashboards für Netzwerk und Shop, und Alarme, an denen Sie die Antworten von shift überprüfen können.

Drei Geschichten für den Anfang

Die Beispielfragen sind auf Englisch, wie die Oberfläche von shift.

Netzwerk

  • Which interfaces flapped in the last six hours, and what is on the other end of each?
  • Why is the uplink of rtr-zrh-1 so full? Who is behind it?

Der Shop

  • Is anything unhealthy in shift-sandbox?
  • Why have checkouts been failing for the last ten minutes?

Ein Alarm

  • ShopErrors fired for checkout. Since when, and which service is behind it?

Alle in der Demo dürfen schauen und fragen; etwas kaputt machen braucht eine Gruppe, die der Betreiber der Demo von Hand vergibt. Fragen Sie mit Ihrem Zugang danach, oder fragen Sie nach den Störungen, die das Netzwerk von selbst plant.
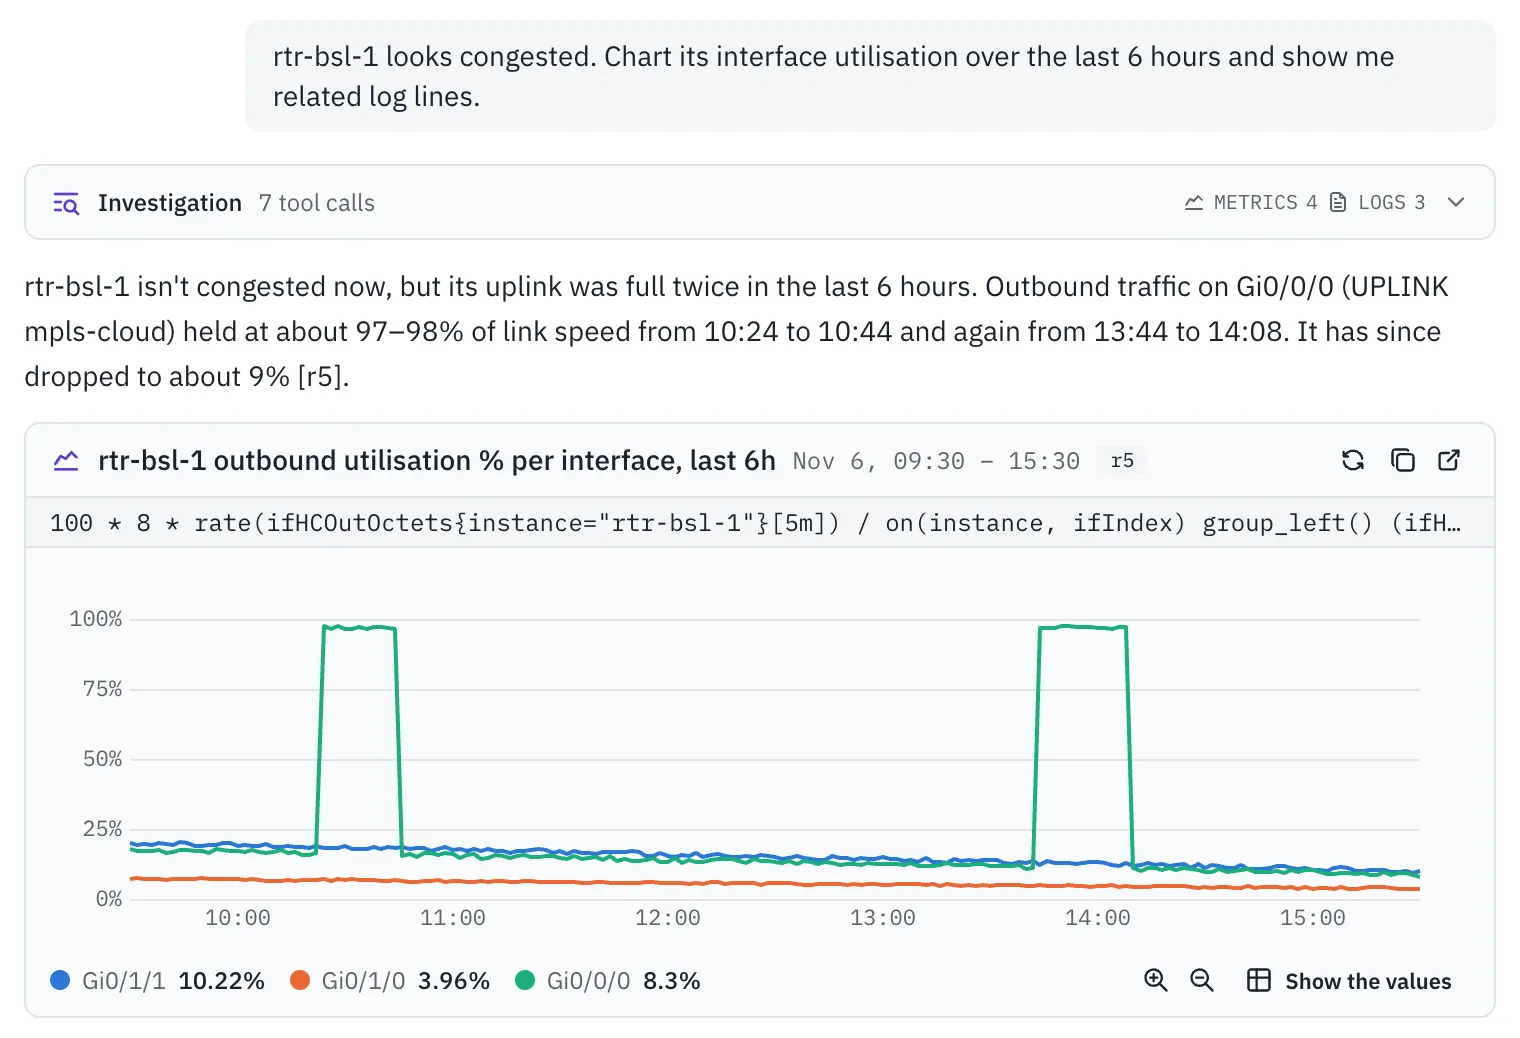
Ein Chat in shift. Die Frage lautet: rtr-bsl-1 looks congested. Chart its interface utilisation over the last 6 hours and show me related log lines. Eine zugeklappte Zeile Investigation zählt 7 Tool-Aufrufe, 4 an Metriken und 3 an Logs. Die Antwort sagt, der Router sei jetzt nicht überlastet, sein Uplink Gi0/0/0 zur MPLS-Cloud sei aber zweimal bei rund 97 bis 98 Prozent der Leitungskapazität gelegen, von 10:24 bis 10:44 und von 13:44 bis 14:08, und liege jetzt bei etwa 9 Prozent. Darunter ein Diagramm der ausgehenden Auslastung pro Interface von 09:30 bis 15:30 mit den zwei Plateaus nahe 100 Prozent, mit seiner MetricsQL-Abfrage, Schaltflächen zum Aktualisieren, Kopieren und Öffnen und einer Legende mit dem letzten Wert jedes Interfaces.
Eine Netzwerk-Frage in einem Entwicklungs-Build mit erfundenen Beispieldaten: das Uplink-Diagramm und die Antwort dazu.
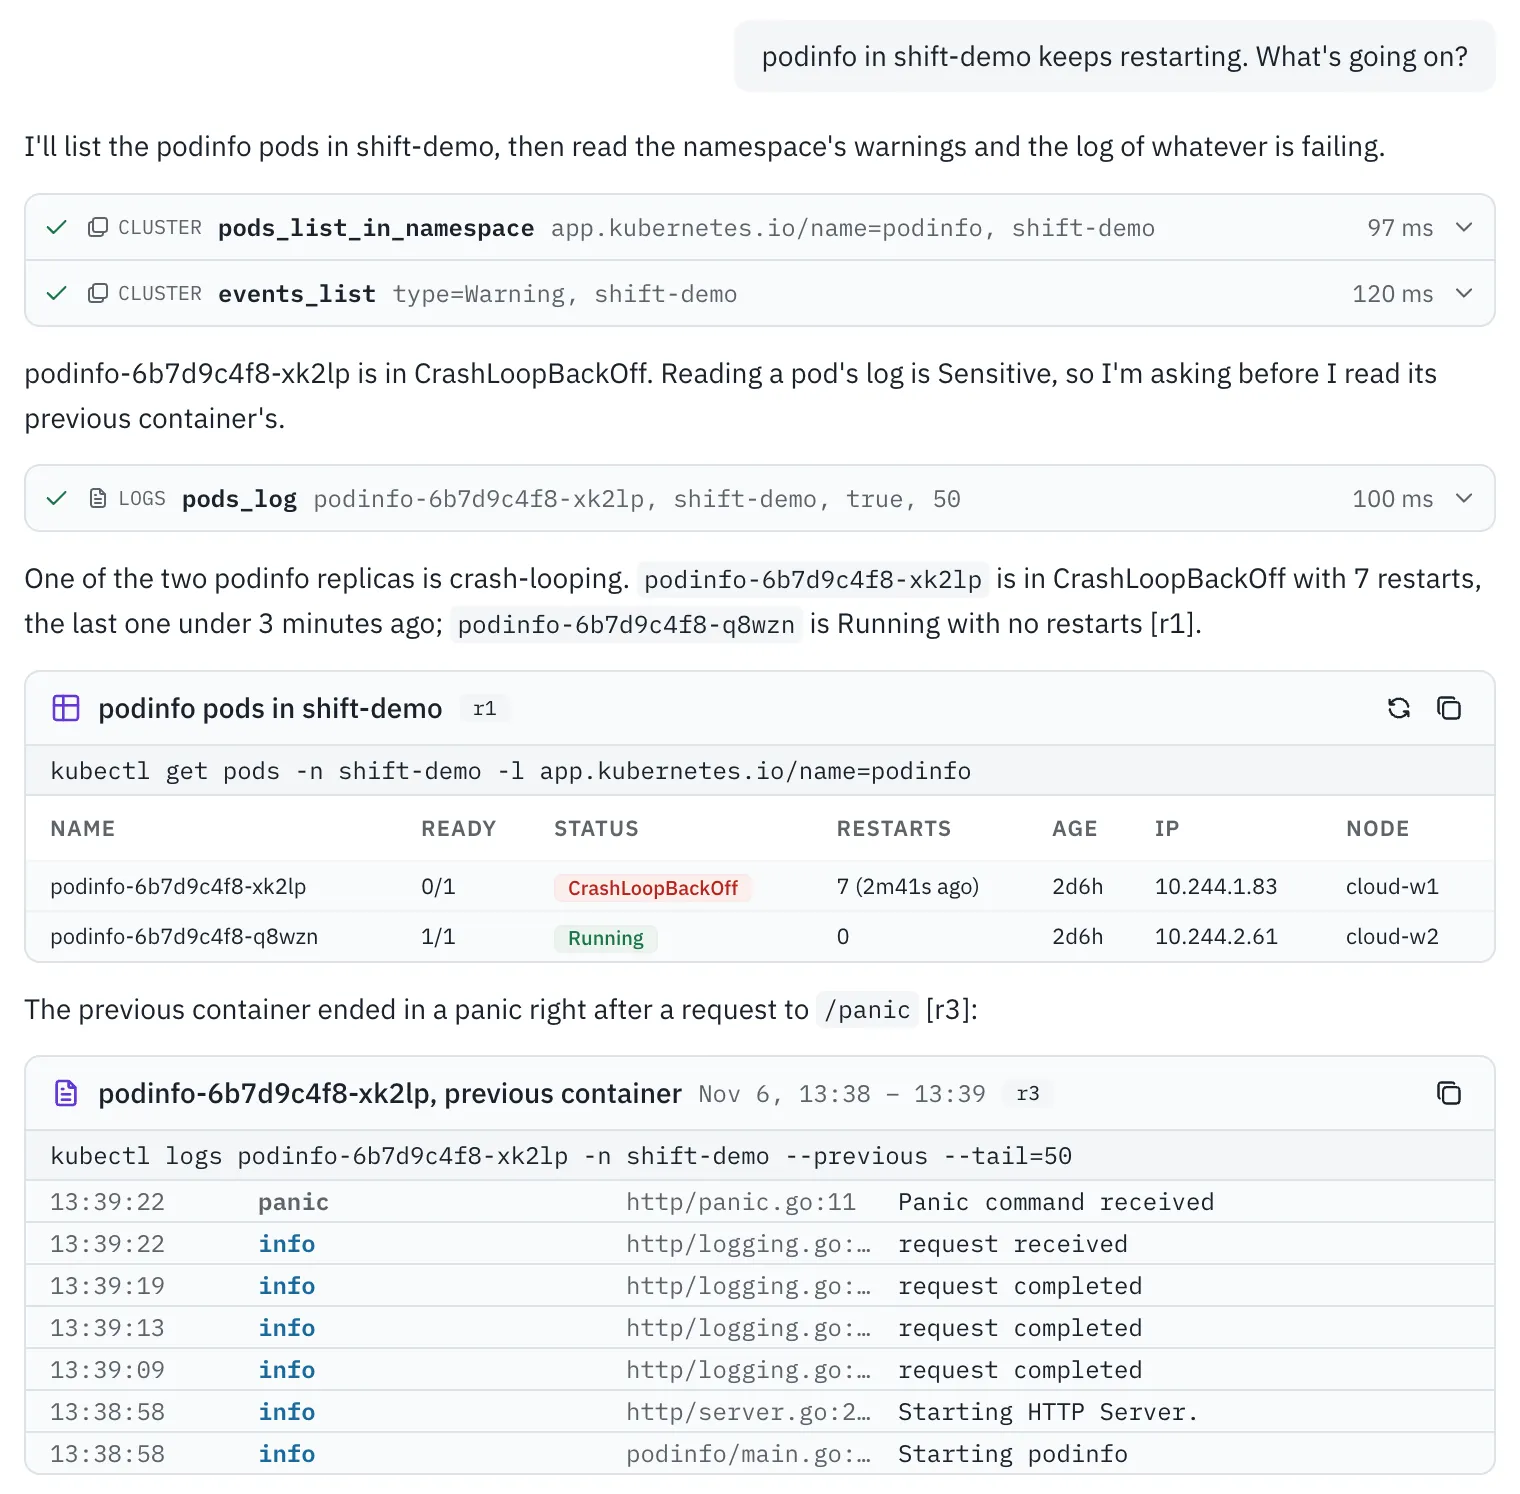
Ein Chat in shift. Die Frage lautet: podinfo in shift-demo keeps restarting. What's going on? Drei Tool-Zeilen zeigen pods_list_in_namespace und events_list auf dem Cluster und pods_log, jede mit Häkchen und Dauer; der Assistent hält fest, dass das Lesen eines Pod-Logs Sensitive ist, und fragt zuerst. Die Antwort sagt, eine der zwei podinfo-Replicas, podinfo-6b7d9c4f8-xk2lp, sei in CrashLoopBackOff mit 7 Neustarts, während podinfo-6b7d9c4f8-q8wzn läuft. Eine Tabelle listet beide Pods mit Bereitschaft, Status, Neustarts, Alter, IP und Node, unter der Zeile kubectl get pods. Eine Log-Karte des vorherigen Containers mit ihrer Zeile kubectl logs zeigt, wie podinfo startet, Anfragen beantwortet, eine Anfrage an /panic erhält und auf Stufe panic Panic command received meldet.
Eine Kubernetes-Frage im selben Build: die Replica in der Crash-Schleife und der Panic im Log ihres vorherigen Containers. Das Log eines Pods zu lesen ist Sensitive, also fragt der Assistent zuerst.

kommt

Demnächst in der Demo

Eine Live-Karte des simulierten Netzwerks, auf der Sie selbst Links und Geräte stören und dann shift fragen, was passiert ist.
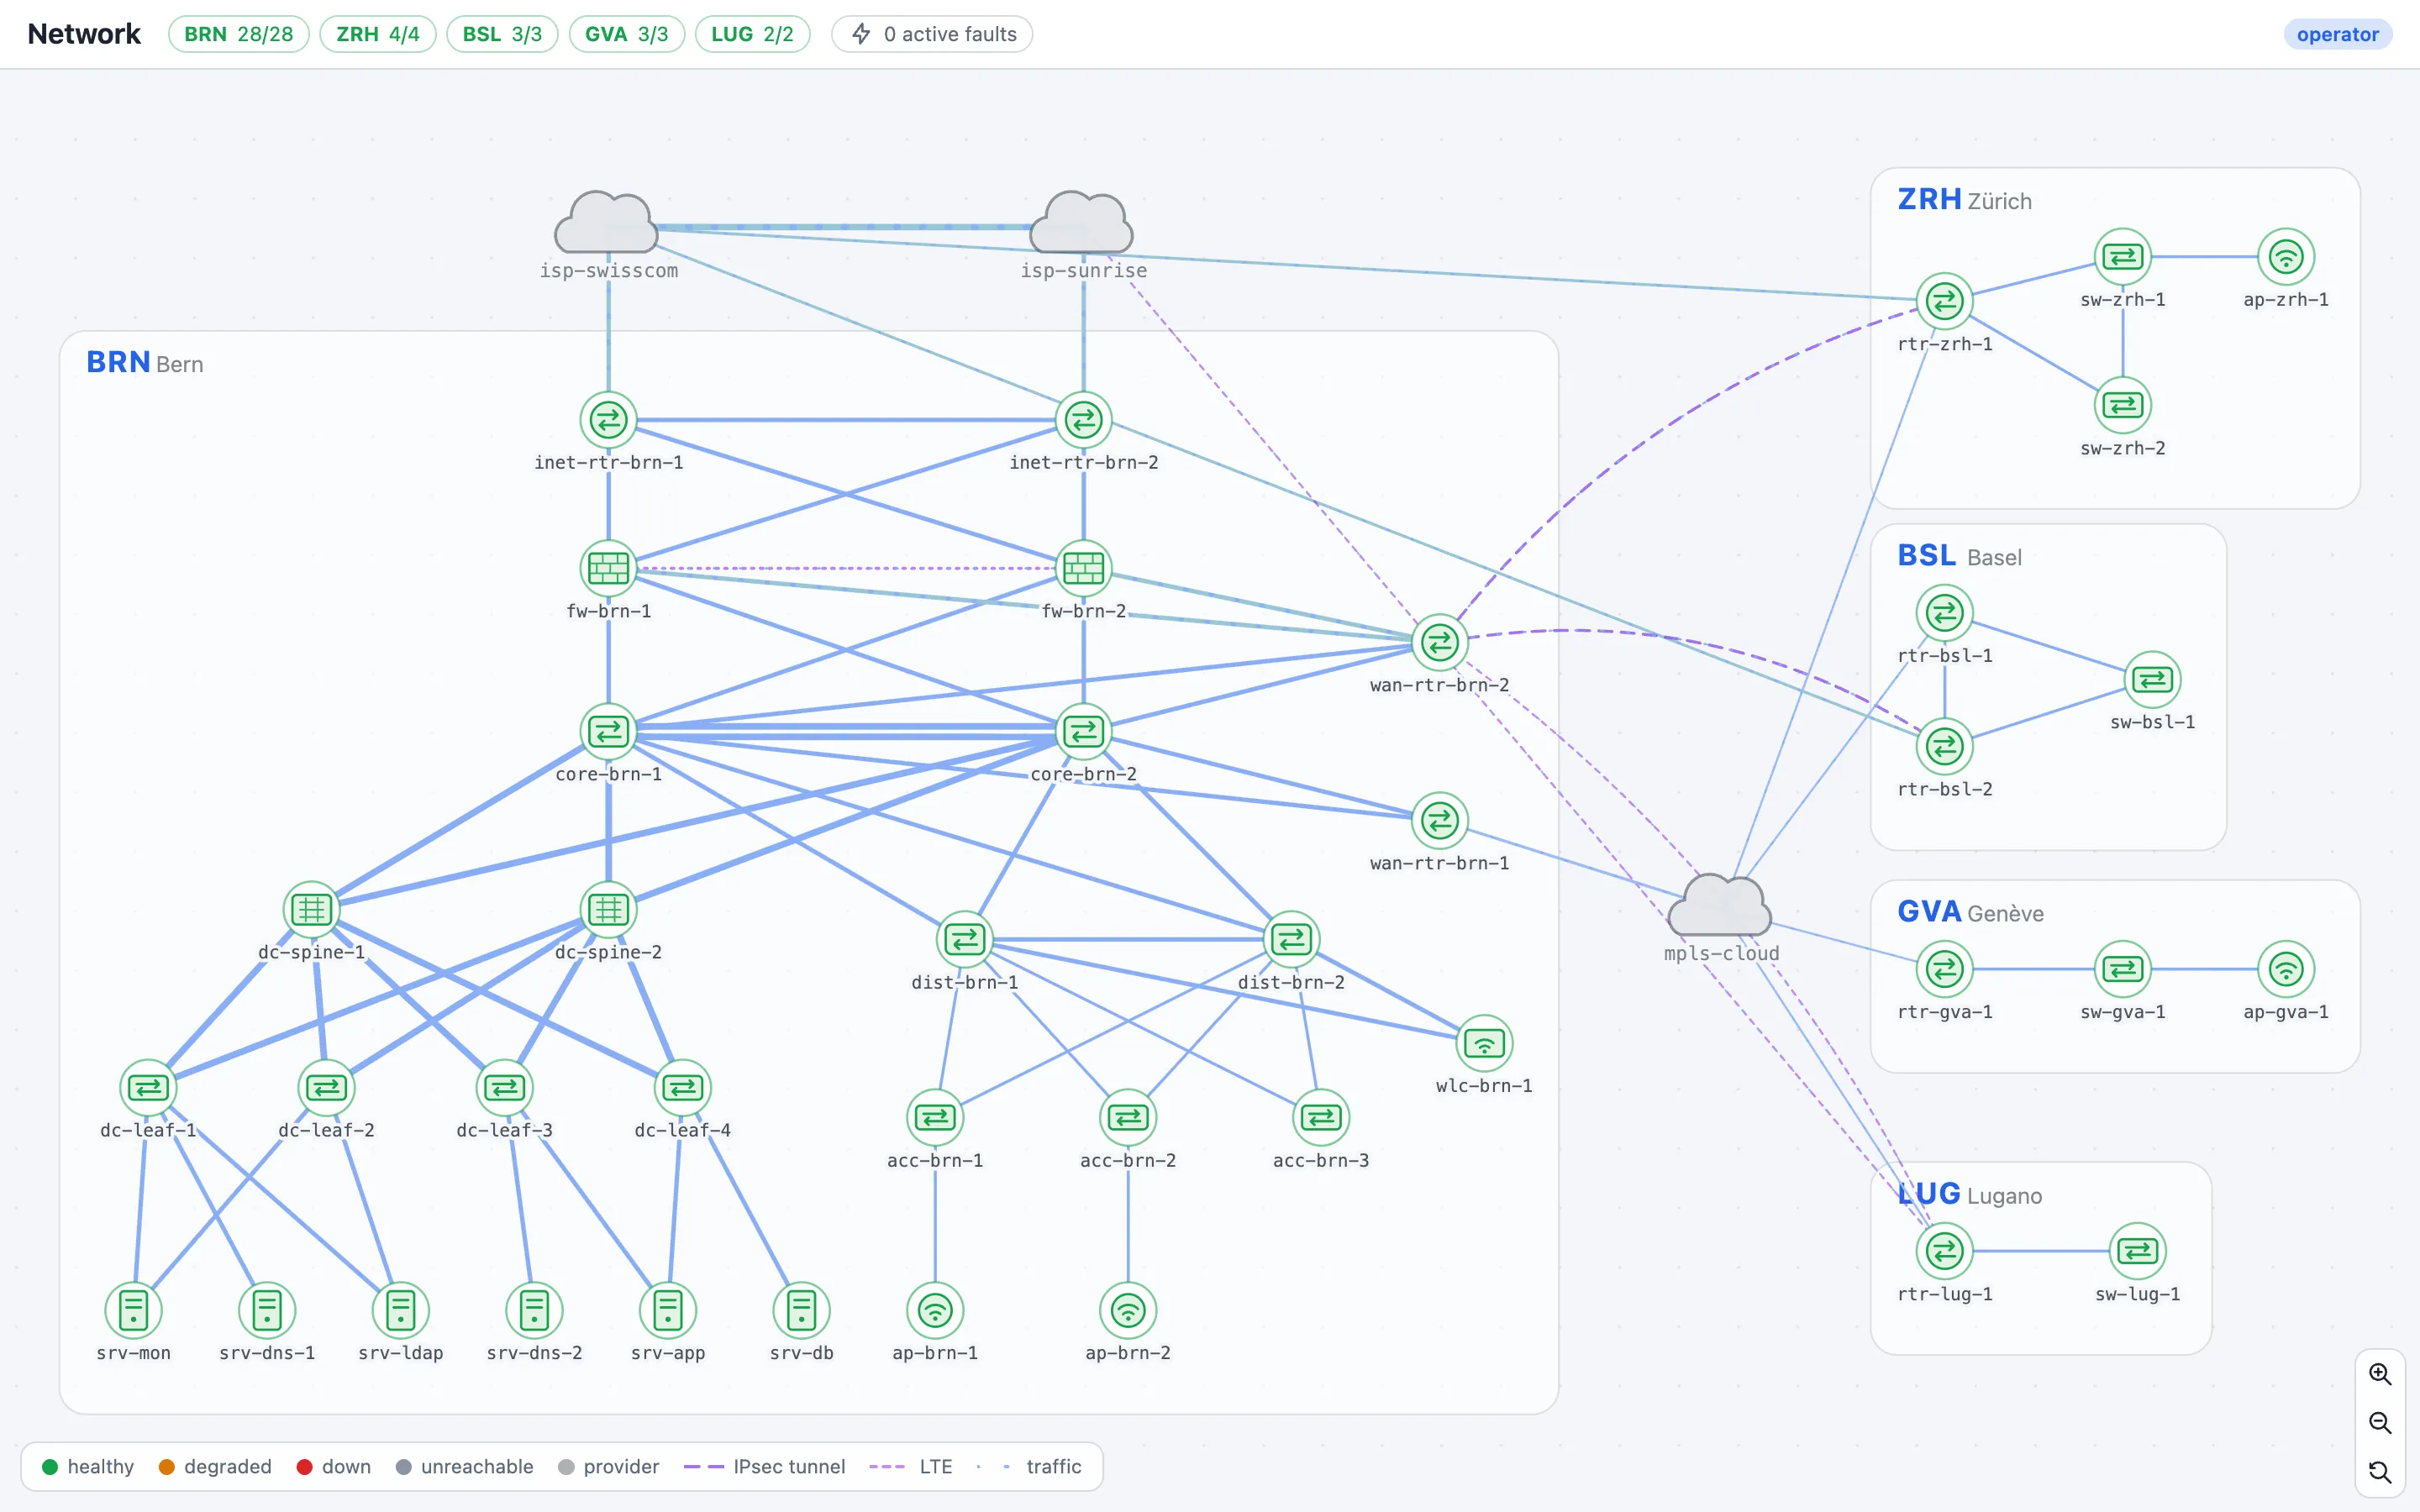
Eine dunkle Netzwerkkarte mit dem Titel Network und den Standort-Anzeigen BRN 28 von 28, ZRH 4 von 4, BSL 3 von 3, GVA 3 von 3, LUG 2 von 2 sowie 0 active faults. Der Standort Bern enthält Internet-Router, Firewalls, Core-, Distribution- und Access-Switches, ein Rechenzentrums-Netz aus Spine und Leaf und Server. Leitungen führen zu den Providern isp-swisscom und isp-sunrise und zu einer mpls-cloud, die Zürich, Basel, Genf und Lugano verbindet; gestrichelte Linien zeigen IPsec-Tunnel und das LTE-Backup. Eine Legende erklärt healthy, degraded, down, unreachable, provider, IPsec tunnel, LTE und traffic.
Die Netzwerkkarte in Entwicklung: die fünf Standorte, ihre Provider, die MPLS-Cloud, IPsec-Tunnel und das LTE-Backup, mit dem Zustand jedes Standorts. Bald in der Demo.